supercalifragilisticexpialidocious

Koji Higasa Blog

Auto-Encoding Variational Bayes - notes

Posted at # ML/AI

言わずと知れた VAE 論文だが, 理論的な骨子は次の2点.

  1. 真の事後分布の近似として, 認識モデルを導入
  2. 再パラメータ化を行い, 効率的な推定器を開発

認識モデル qϕ(z∣x)q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}) の導入

変分下限 (variational lower bound) L(θ,ϕ;x(i))\mathcal{L}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)}) の最大化に帰着.

— 記法と仮定 —

— log⁡pθ(x(i))\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}) の計算 —

    log⁡pθ(x(i))=∫qϕ(z∣x(i))log⁡pθ(x(i))dz=∫qϕ(z∣x(i))log⁡[pθ(x(i),z)pθ(x(i))pθ(x(i),z)]dz=∫qϕ(z∣x(i))log⁡[pθ(x(i),z)pθ(z∣x(i))]dz=∫qϕ(z∣x(i))log⁡[pθ(x(i)∣z)pθ(z)pθ(z∣x(i))]dz=∫qϕ(z∣x(i))log⁡[qϕ(z∣x(i))pθ(z∣x(i))pθ(z)qϕ(z∣x(i))pθ(x(i)∣z)]dz=DKL(qϕ(z∣x(i))∥pθ(z∣x(i)))  −DKL(qϕ(z∣x(i))∥pθ(z))+Eqϕ(z∣x(i))[log⁡pθ(x(i)∣z)]≔DKL(qϕ(z∣x(i))∥pθ(z∣x(i)))+L(θ,ϕ;x(i))\begin{align} &\space\space\space\space\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}) \\ &= ∫q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)})\mathrm{d}\mathbf{z} \\ &= ∫q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\log\left[p_{\mathbf{\theta}}(\mathbf{x}^{(i)},\mathbf{z})\frac{p_{\mathbf{\theta}}(\mathbf{x}^{(i)})}{p_{\mathbf{\theta}}(\mathbf{x}^{(i)},\mathbf{z})}\right]\mathrm{d}\mathbf{z} \\ &= ∫q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\log\left[\frac{p_{\mathbf{\theta}}(\mathbf{x}^{(i)},\mathbf{z})}{p_{\mathbf{\theta}}(\mathbf{z}|\mathbf{x}^{(i)})}\right]\mathrm{d}\mathbf{z} \\ &= ∫q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\log\left[\frac{p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z})p_{\mathbf{\theta}}(\mathbf{z})}{p_{\mathbf{\theta}}(\mathbf{z}|\mathbf{x}^{(i)})}\right]\mathrm{d}\mathbf{z} \\ &= ∫q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\log\left[\frac{q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})}{p_{\mathbf{\theta}}(\mathbf{z}|\mathbf{x}^{(i)})}\frac{p_{\mathbf{\theta}}(\mathbf{z})}{q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})}p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z})\right]\mathrm{d}\mathbf{z} \\ &= D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z}|\mathbf{x}^{(i)})\right) \\ &\space\space-D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right)+\mathbb{E}_{q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})}\left[\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z})\right] \\ &≔ D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z}|\mathbf{x}^{(i)})\right)+\mathcal{L}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)}) \end{align}

— L(θ,ϕ;x(i))\mathcal{L}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)}) 各項の解釈 —

  1. DKL(qϕ(z∣x(i))∥pθ(z))D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right): 正則化項, エンコーダが事前分布から離れ過ぎないように圧力をかける. 小さくしたい.
  2. Eqϕ(z∣x(i))[log⁡pθ(x(i)∣z)]\mathbb{E}_{q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})}\left[\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z})\right]: 期待される負の再構成誤差, デコーダによる尤度が高ければ誤差は小さい. 大きくしたい.

再パラメータ化トリック

ランダム変数を決定論的変数へ書き換えることで, 変分下限に新たな表現(推定器)を与える.

— トリック —

ランダムサンプリング z∼qϕ(z∣x)\mathbf{z}∼q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}) を連続変数, かつパラメータ ϕ\mathbf{\phi} に対して微分可能と仮定すると, ある独立周辺分布 p(ϵ)p(\mathbf{ϵ}) によってサンプルされるノイズ変数 ϵ\mathbf{ϵ}, および ϕ\mathbf{\phi} によってパラメータ付けされたあるベクトル値関数 gϕ(.)g_{\mathbf{\phi}}(.) を用いて, 潜在変数 z\mathbf{z} は次のように再パラメータ化される.

z=gϕ(ϵ,x)  with  ϵ∼p(ϵ)\mathbf{z} = g_{\mathbf{\phi}}(\mathbf{ϵ},\mathbf{x})\space\space\mathrm{with}\space\space \mathbf{{ϵ}}∼p(\mathbf{{ϵ}})

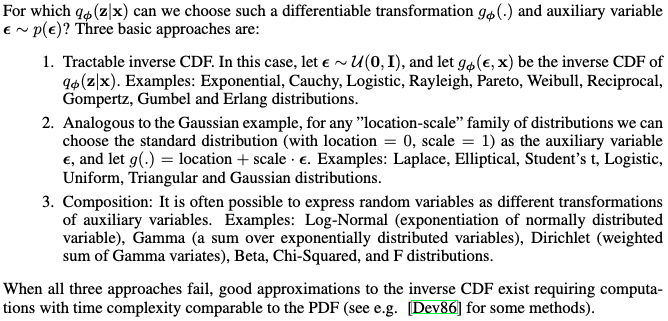
p(ϵ)p(\mathbf{ϵ}) や gϕ(.)g_{\mathbf{\phi}}(.) は以下のように選べばいい. reparameterization

— 確率勾配変分 Bayes (SGVB) 推定器 L~(θ,ϕ;x(i))\tilde{\mathcal{L}}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)}) —

    L~(θ,ϕ;x(i))=−DKL(qϕ(z∣x(i))∥pθ(z))+Eqϕ(z∣x(i))[log⁡pθ(x(i)∣gϕ(ϵ,x(i)))]=−DKL(qϕ(z∣x(i))∥pθ(z))+∫qϕ(z∣x(i))log⁡pθ(x(i)∣gϕ(ϵ,x(i)))dz=−DKL(qϕ(z∣x(i))∥pθ(z))+∫p(ϵ)log⁡pθ(x(i)∣gϕ(ϵ,x(i)))dϵ≃−DKL(qϕ(z∣x(i))∥pθ(z))+1L∑l=1Llog⁡pθ(x(i)∣gϕ(ϵ(l),x(i)))  ∵Monte Carlo 法≔−DKL(qϕ(z∣x(i))∥pθ(z))+1L∑l=1Llog⁡pθ(x(i)∣z(i,l))\begin{align} &\space\space\space\space\tilde{\mathcal{L}}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)}) \\ &= -D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right)+\mathbb{E}_{q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})}\left[\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|g_{\mathbf{\phi}}(\mathbf{ϵ},\mathbf{x}^{(i)}))\right] \\ &= -D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right)+∫q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|g_{\mathbf{\phi}}(\mathbf{ϵ},\mathbf{x}^{(i)}))\mathrm{d}\mathbf{z} \\ &= -D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right)+∫p(\mathbf{ϵ})\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|g_{\mathbf{\phi}}(\mathbf{ϵ},\mathbf{x}^{(i)}))\mathrm{d}\mathbf{ϵ} \\ &≃ -D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right)+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|g_{\mathbf{\phi}}(\mathbf{ϵ}^{(l)},\mathbf{x}^{(i)})) \\ &\space\space∵ \mathrm{Monte\ Carlo\ 法} \\ &≔ -D_{\text{KL}}\left(q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})\|p_{\mathbf{\theta}}(\mathbf{z})\right)+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z}^{(i,l)}) \end{align}

— Auto-Encoding 変分 Bayes (AEVB) アルゴリズム —

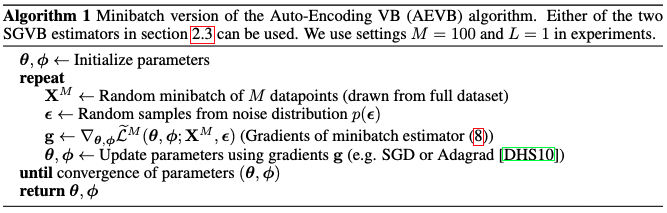
最終的なアルゴリズム. データの一部 (NN データ点の内 MM 点) により結果を再現する, 次のミニバッチ法も含む.

L(θ,ϕ;x(i))≃L~M(θ,ϕ;XM)=NM∑i=1ML~(θ,ϕ;x(i))\mathcal{L}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)})≃\tilde{\mathcal{L}}^M(\mathbf{\theta},\mathbf{\phi};\mathbf{X}^{M})=\frac{N}{M}\sum_{i=1}^M\tilde{\mathcal{L}}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)})

AEVB

変分 Auto-Encoder (VAE)

以下のように選んだものを VAE と呼ぶ.

  1. pθ(z)=N(z;0,I)p_{\mathbf{\theta}}(\mathbf{z})=\mathcal{N}(\mathbf{z};\mathbf{0},\mathbf{I}).
  2. pθ(x∣z)=p_{\mathbf{\theta}}(\mathbf{x}|\mathbf{z})=多変量 Gauss/Bernoulli 分布. パラメータ θ\mathbf{\theta} は多層パーセプトロン (MLP) により z\mathbf{z} から計算される.
  3. qϕ(z∣x(i))=N(z;μ(i),σ2(i)I)q_{\mathbf{\phi}}(\mathbf{z}|\mathbf{x}^{(i)})=\mathcal{N}(\mathbf{z};\mathbf{\mu}^{(i)},\mathbf{\sigma}^{2(i)}\mathbf{I}). 平均 μ\mathbf{\mu}, および標準偏差 σ\mathbf{\sigma} (併せてパラメータ ϕ\mathbf{\phi}) も MLP により x(i)\mathbf{x}^{(i)} から計算される.

— 推定器の具体的表式 —

    L(θ,ϕ;x(i))≃−DKL(N(z;μ(i),σ2(i)I)∥N(z;0,I))+1L∑l=1Llog⁡pθ(x(i)∣z(i,l))=EN(z;μ(i),σ2(i)I)[log⁡N(z;0,I)−log⁡N(z;μ(i),σ2(i)I)]  +1L∑l=1Llog⁡pθ(x(i)∣z(i,l))=EN(z;μ(i),σ2(i)I)[−12∑j=1J{log⁡(2π)+zj2(i)}+12∑j=1J{log⁡(2πσj2(i))+(zj(i)−μj(i))2σj2(i)}]  +1L∑l=1Llog⁡pθ(x(i)∣z(i,l))=12∑j=1J{−log⁡(2π)−(μj2(i)+σj2(i))+log⁡(2πσj2(i))+σj2(i)σj2(i)}  +1L∑l=1Llog⁡pθ(x(i)∣z(i,l))=12∑j=1J(1+log⁡(σj2(i))−μj2(i)−σj2(i))+1L∑l=1Llog⁡pθ(x(i)∣z(i,l))\begin{align} &\space\space\space\space\mathcal{L}(\mathbf{\theta},\mathbf{\phi};\mathbf{x}^{(i)}) \\ &≃ -D_{\text{KL}}\left(\mathcal{N}(\mathbf{z};\mathbf{\mu}^{(i)},\mathbf{\sigma}^{2(i)}\mathbf{I})\|\mathcal{N}(\mathbf{z};\mathbf{0},\mathbf{I})\right)+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z}^{(i,l)}) \\ &= \mathbb{E}_{\mathcal{N}(\mathbf{z};\mathbf{\mu}^{(i)},\mathbf{\sigma}^{2(i)}\mathbf{I})}\left[\log\mathcal{N}(\mathbf{z};\mathbf{0},\mathbf{I})-\log\mathcal{N}(\mathbf{z};\mathbf{\mu}^{(i)},\mathbf{\sigma}^{2(i)}\mathbf{I})\right] \\ &\space\space+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z}^{(i,l)}) \\ &= \mathbb{E}_{\mathcal{N}(\mathbf{z};\mathbf{\mu}^{(i)},\mathbf{\sigma}^{2(i)}\mathbf{I})}\left[-\frac{1}{2}\sum_{j=1}^J\left\lbrace\log(2\pi)+z_j^{2(i)}\right\rbrace+\frac{1}{2}\sum_{j=1}^J\left\lbrace\log(2\pi\sigma_j^{2(i)})+\frac{\left(z_j^{(i)}-\mu_j^{(i)}\right)^2}{\sigma_j^{2(i)}}\right\rbrace\right] \\ &\space\space+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z}^{(i,l)}) \\ &= \frac{1}{2}\sum_{j=1}^J\left\lbrace-\log(2\pi)-\left(\mu_j^{2(i)}+\sigma_j^{2(i)}\right)+\log(2\pi\sigma_j^{2(i)})+\frac{\sigma_j^{2(i)}}{\sigma_j^{2(i)}}\right\rbrace \\ &\space\space+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z}^{(i,l)}) \\ &= \frac{1}{2}\sum_{j=1}^J\left(1+\log(\sigma_j^{2(i)})-\mu_j^{2(i)}-\sigma_j^{2(i)}\right)+\frac{1}{L}\sum_{l=1}^L\log p_{\mathbf{\theta}}(\mathbf{x}^{(i)}|\mathbf{z}^{(i,l)}) \end{align}

ここで, Hadamard 積 ⊙\odot として, z(i,l)=μ(i)+σ(i)⊙ϵ(l)  and  ϵ(l)∼N(0,I)\mathbf{z}^{(i,l)}=\mathbf{\mu}^{(i)}+\mathbf{\sigma}^{(i)}\odot\mathbf{ϵ}^{(l)}\space\space\mathrm{and}\space\space\mathbf{ϵ}^{(l)}∼\mathcal{N}(\mathbf{0},\mathbf{I}).